Ray 集群管理
点击左侧导航栏 智能服务 > Ray 集群管理,查看当前工作空间中的 Ray 集群。页面可以切换两种集群类型:
| 集群类型 | 创建方式 | 生命周期 |
|---|---|---|
| Standalone | 在集群管理页创建 | 多个任务可复用;任务结束后保留,由用户启停、编辑或删除 |
| RayJob-managed | 发布任务时选择 RayJob-managed,运行时创建 | 属于对应 RayJob,按该任务的清理配置回收,也可在管理页清理 |
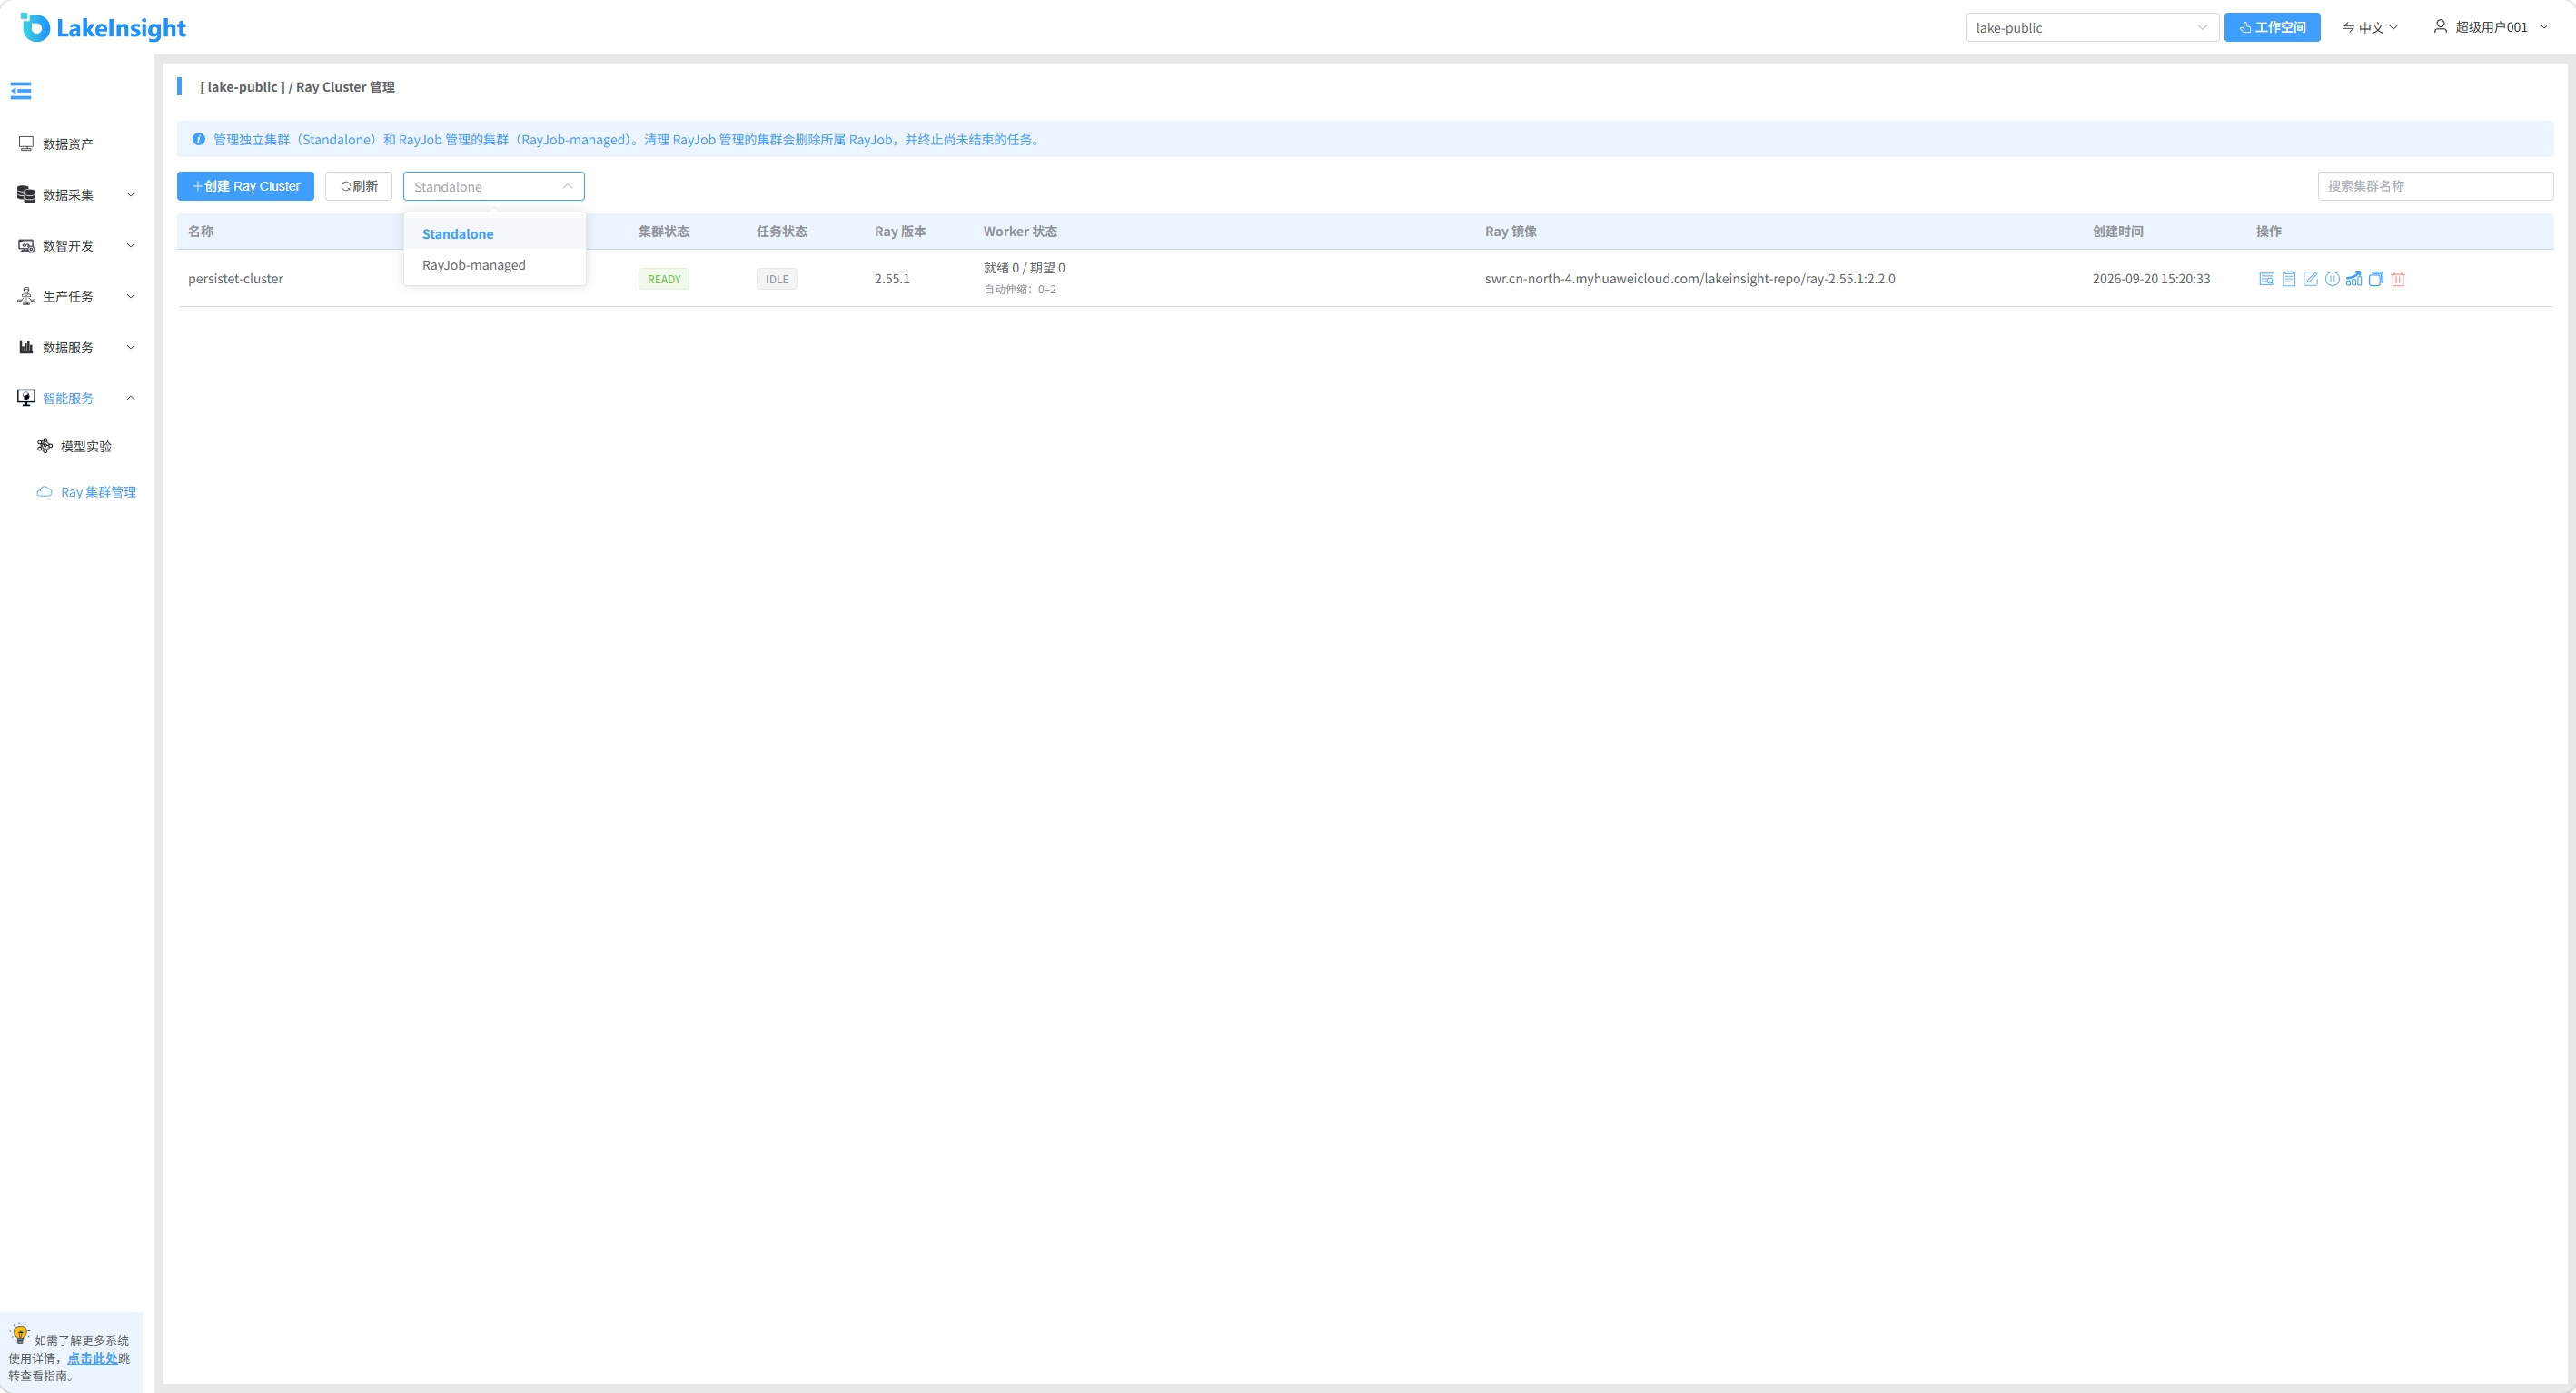
集群类型下拉框用于切换 Standalone 和 RayJob-managed 列表。列表展示集群状态、任务状态、Ray 版本、Worker 状态、镜像和创建时间:
- 集群状态表示 RayCluster 本身是否可用,例如
READY表示集群已就绪,SUSPENDED表示 Standalone 集群已停止。正在创建、启动或异常的集群需要结合详情和诊断日志继续判断。 - 任务状态表示 RayJob 的运行状态,与集群状态相互独立。Standalone 集群可以没有所属任务;RayJob-managed 集群会显示所属任务状态或残留集群提示。
- Worker 状态中的“就绪 N / 期望 M”分别表示当前已就绪和当前期望的 Worker 数量;自动伸缩集群的期望数量会随负载变化。
创建 Standalone 集群
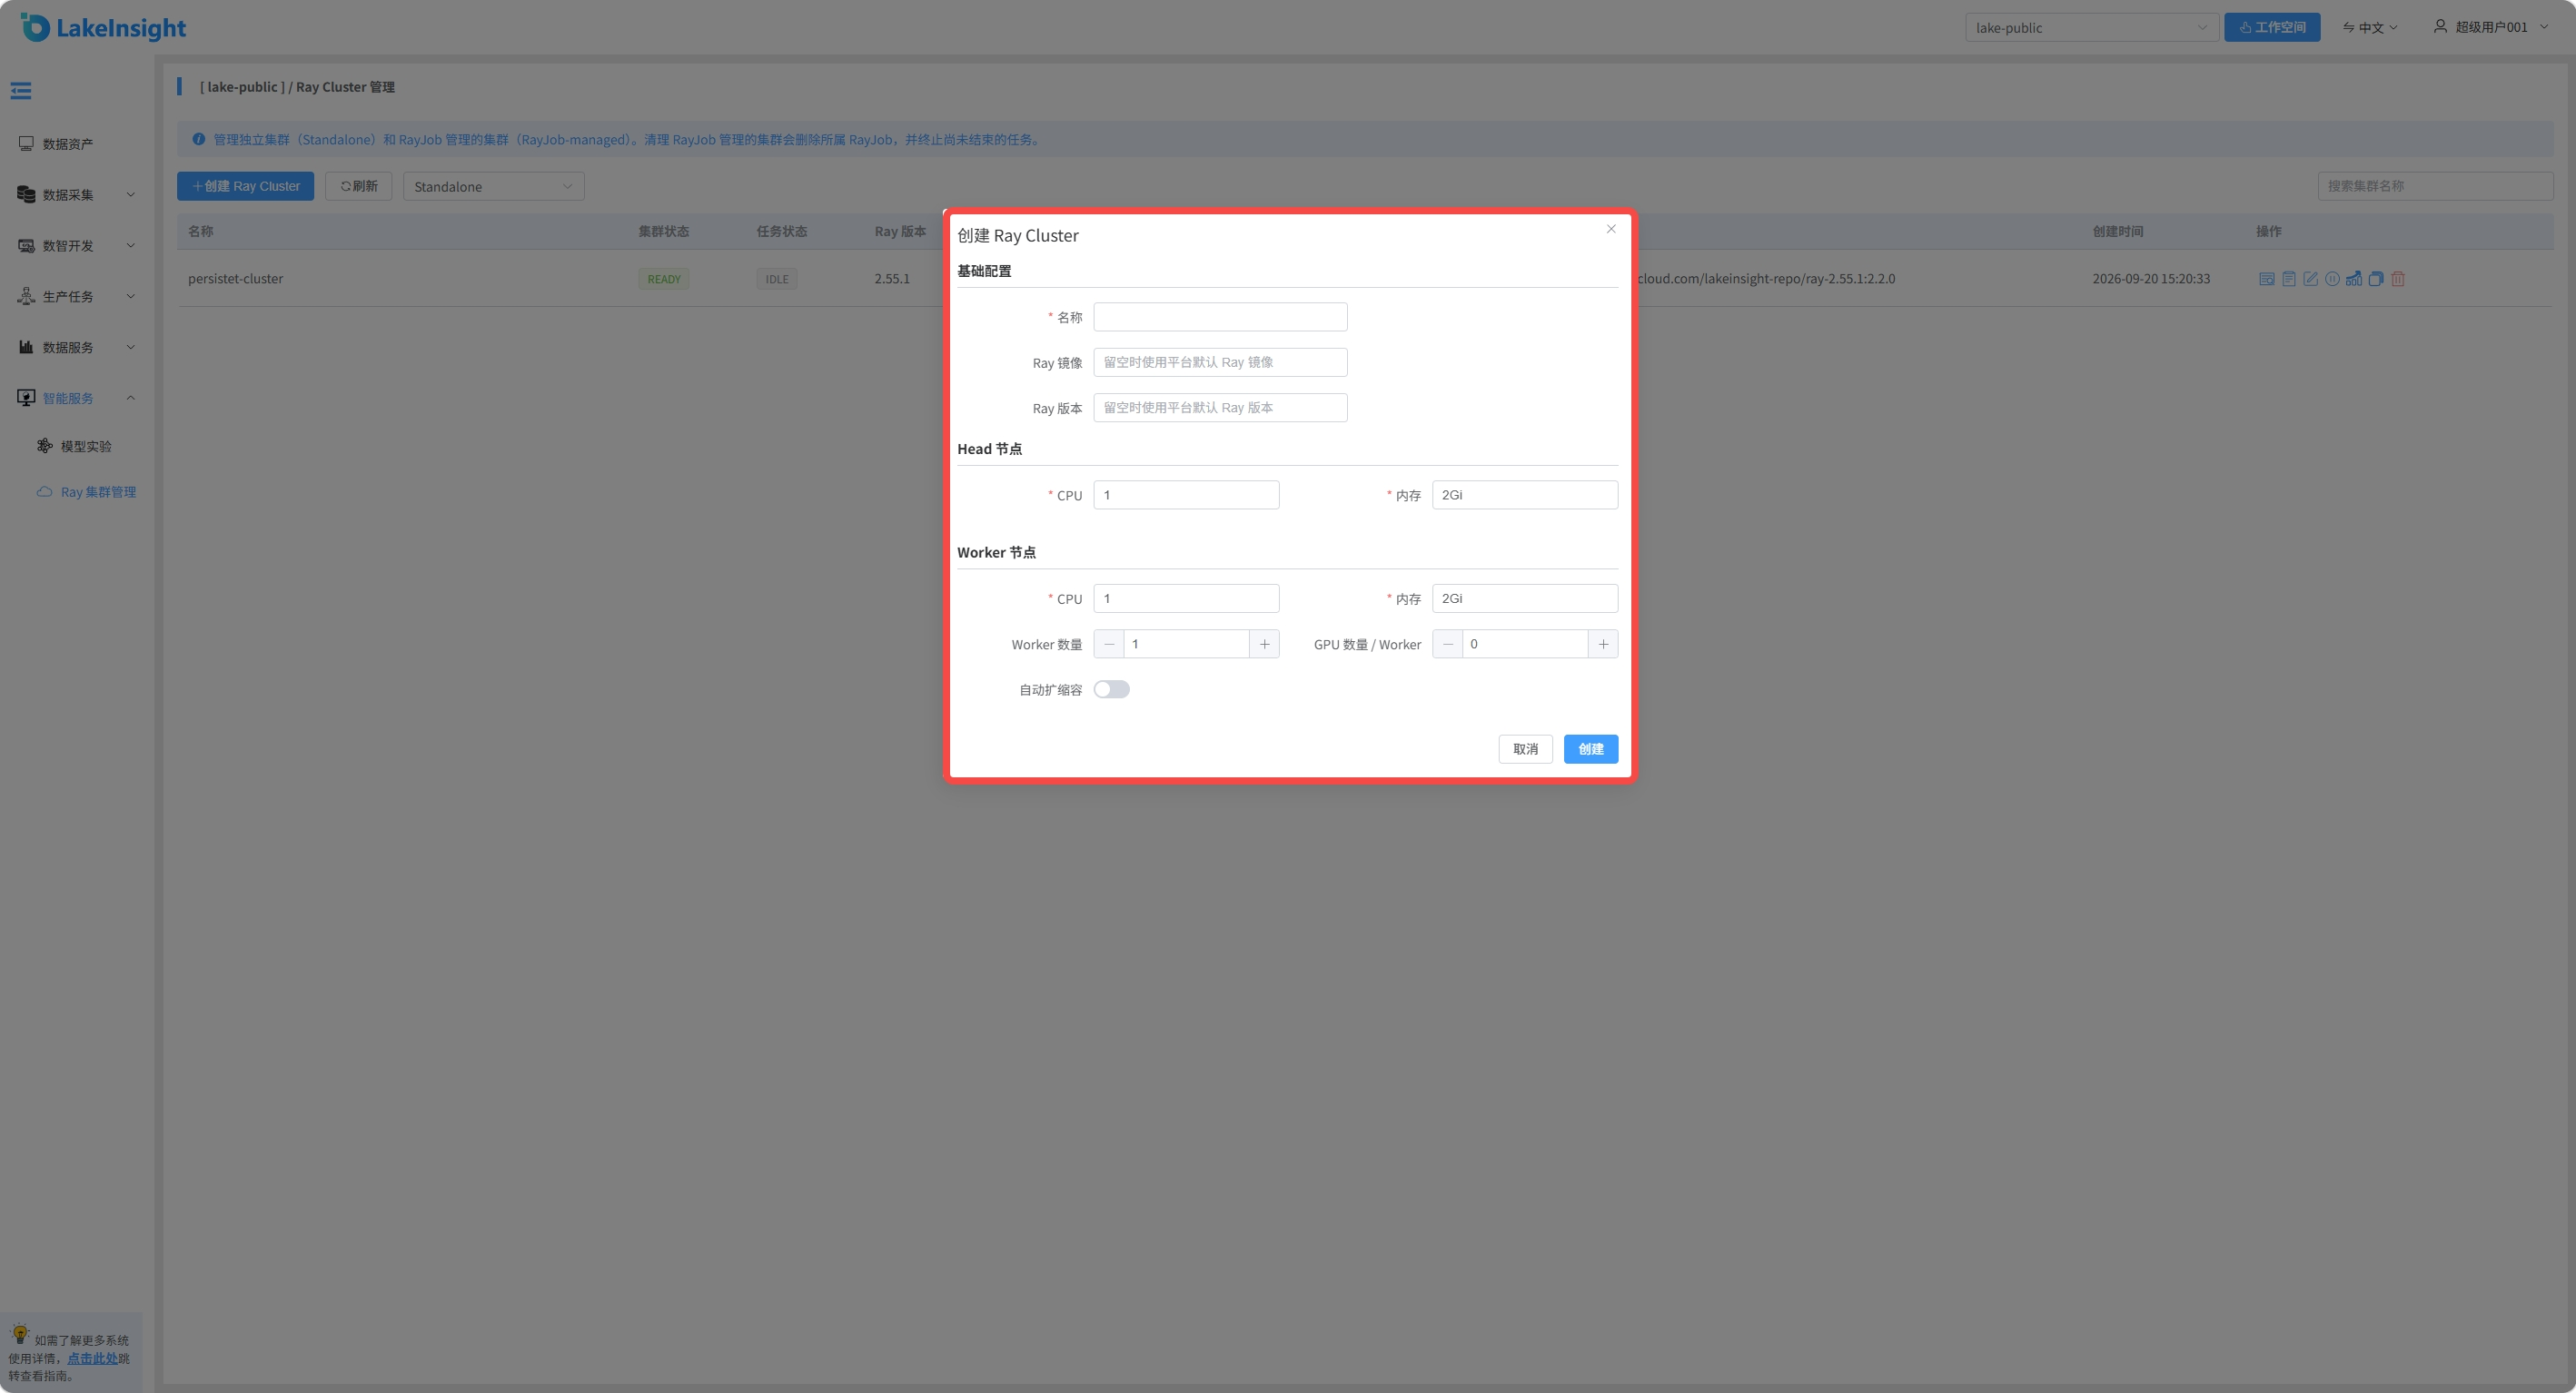
点击 创建 Ray Cluster,填写名称、Ray 版本、镜像以及 Head/Worker 资源配置。
- 名称:使用小写字母、数字和连字符,以字母或数字开头和结尾。
- Ray 版本 / Ray 镜像:可以自定义,镜像内的 Ray 版本应与填写的版本一致。镜像留空时,GPU / Worker 大于
0使用平台默认 GPU 镜像,否则使用默认 CPU 镜像。填写自定义镜像时不会自动替换。 - Head CPU / 内存:用于 Head Pod。当前配置将 Head 的 Ray 可调度 CPU 设为
0,计算任务使用 Worker。 - Worker CPU / 内存:每个 Worker Pod 的资源,不是整个集群的总资源。
- GPU / Worker:每个 Worker 申请的 NVIDIA GPU 数量,默认
0,通过nvidia.com/gpu分配。需要节点已提供相应 GPU 资源且镜像包含兼容的运行依赖;当前该输入不支持 AMD GPU 资源名。 - 自动扩缩容:关闭时按 Worker 数量创建固定规模;开启时配置 Worker 数下限和上限,初始 Worker 数采用下限。
自动扩缩容关闭时,直接填写 Worker 数量。例如 Worker 数量为 1,集群会维持一个 Worker;每个 Worker 分别使用表单中填写的 CPU、内存和 GPU 数量。
例如:开启自动扩缩容,下限 0、上限 2,初始可以只有一个 Head、没有 Worker;提交需要计算资源的任务后再按需求扩容。上限 2 表示最多两个 Worker,不包括 Head。
开启自动扩缩容后,固定的 Worker 数量会替换为 Worker 数下限和Worker 数上限。Head、Worker 单节点资源、GPU 和镜像等其他参数含义不变。下限决定集群启动时至少保留多少个 Worker,上限限制自动扩容的最大 Worker 数。
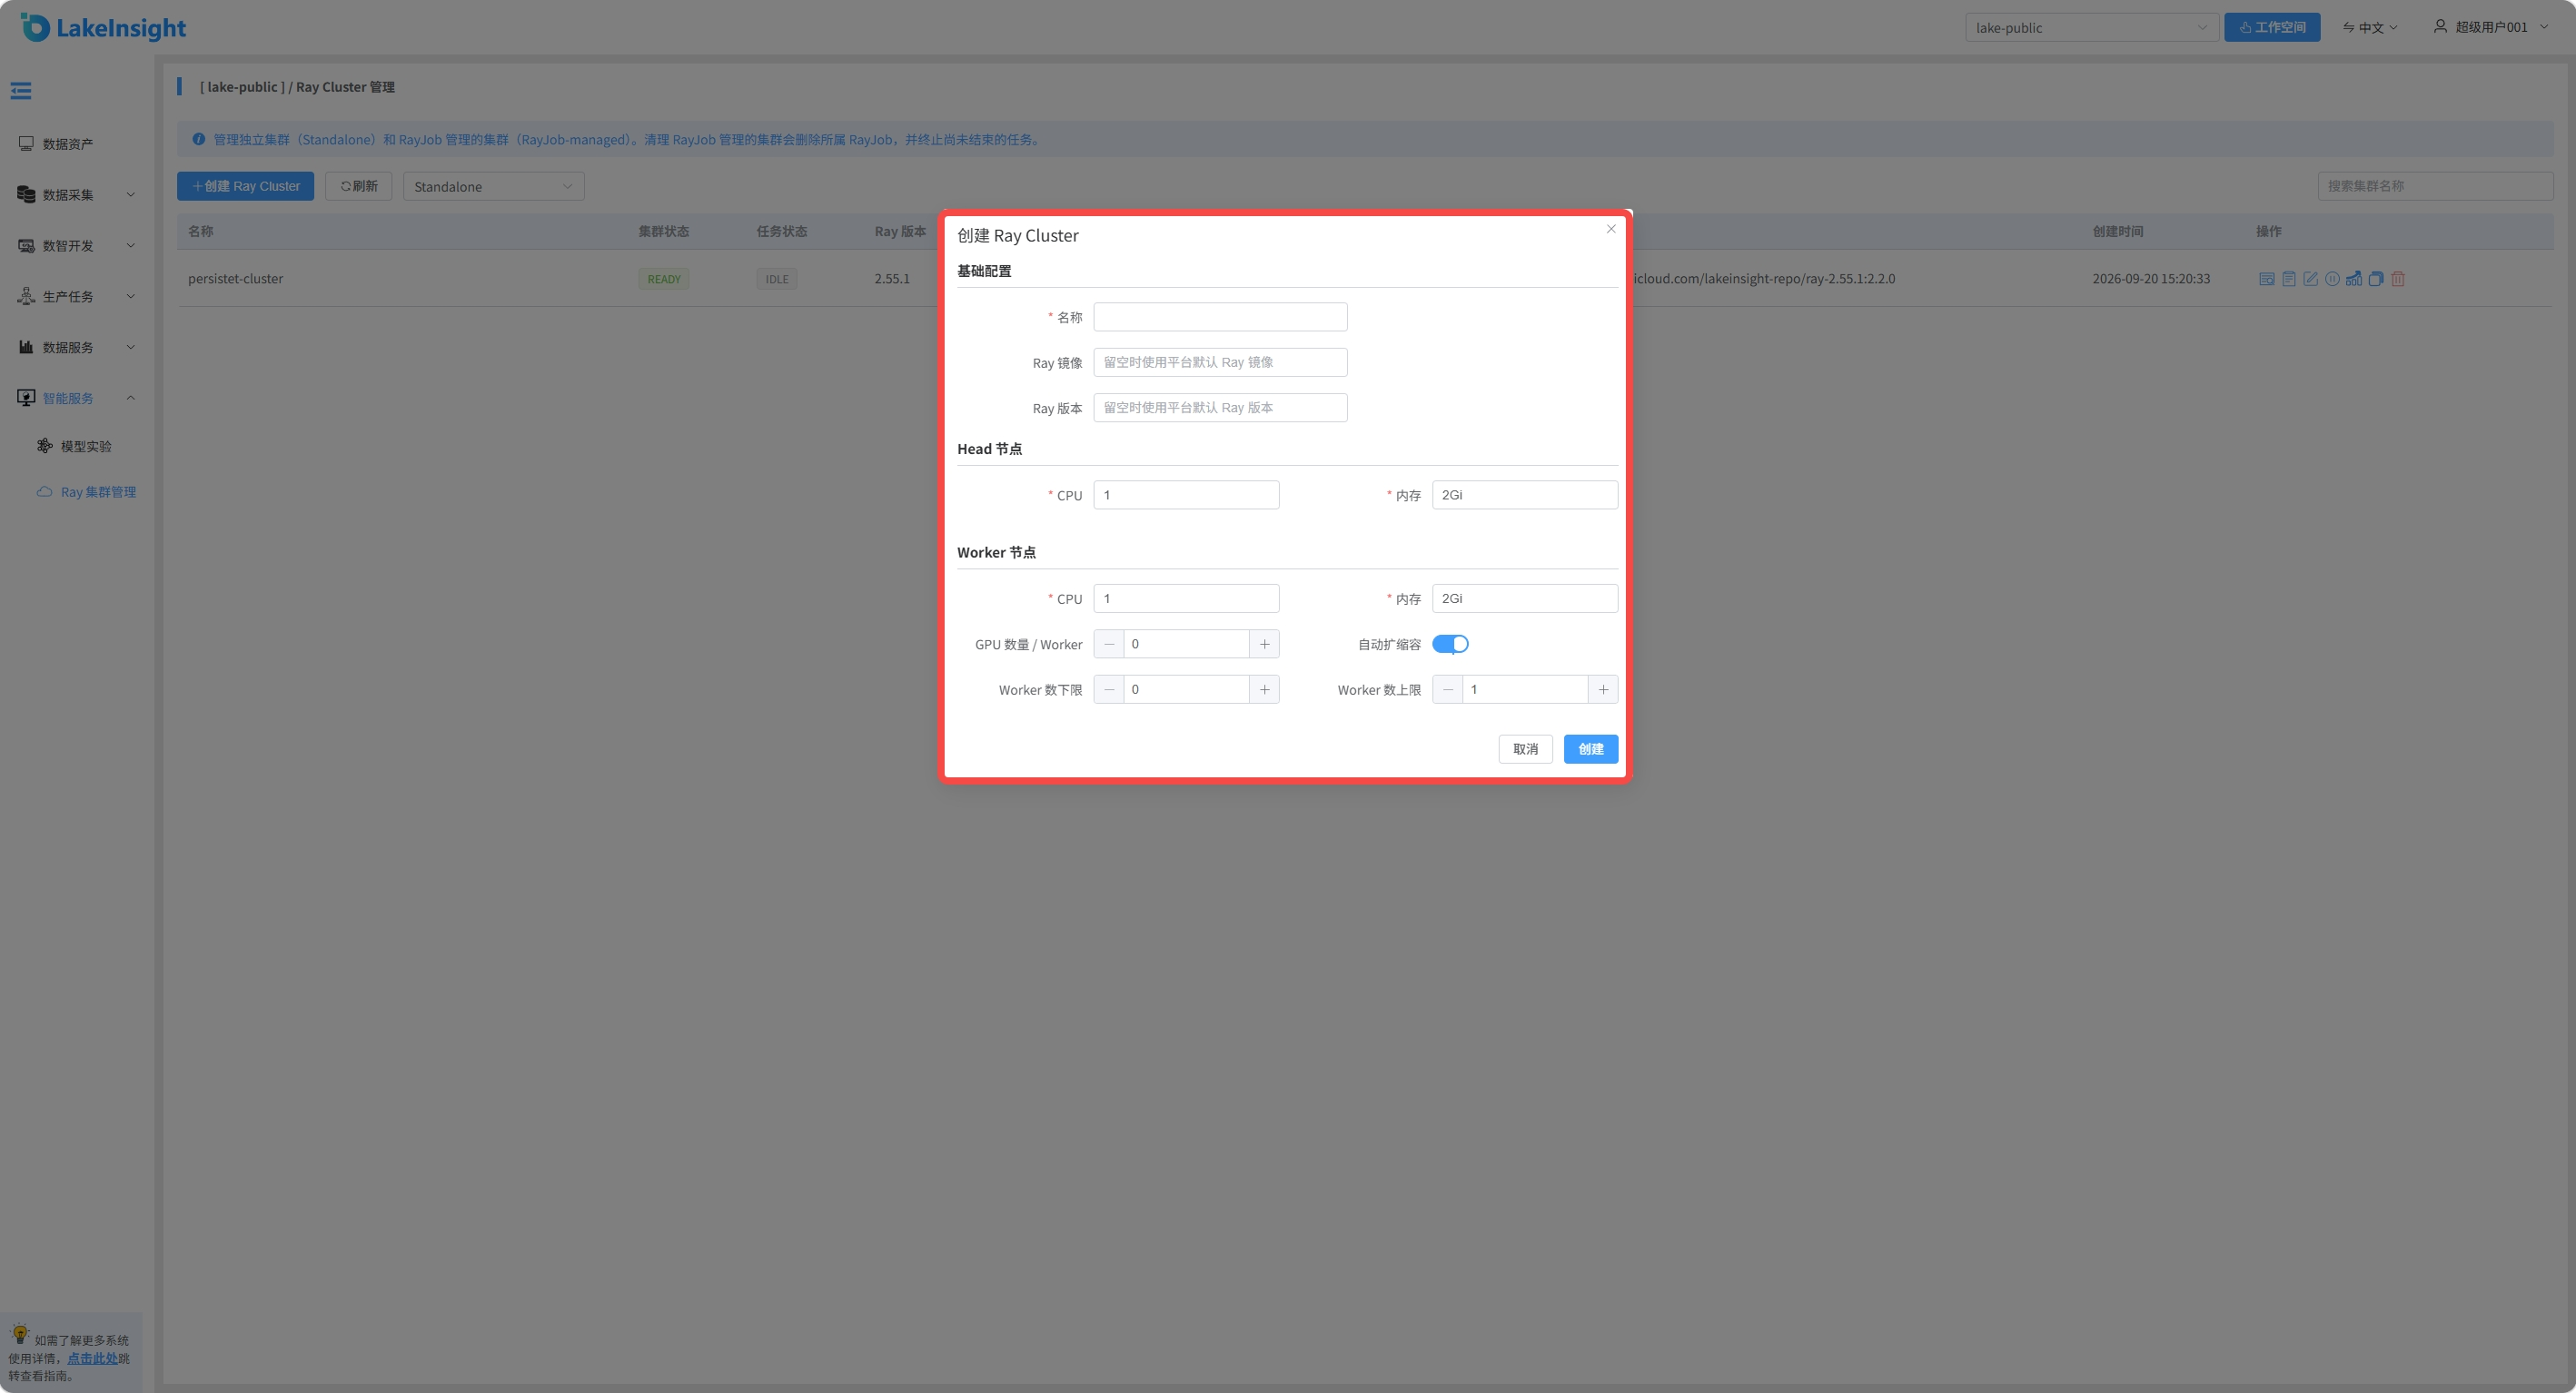
创建请求提交成功后,需要等待集群达到 READY,才能在任务发布或编辑配置中选择它。
查看状态和资源
- 集群状态反映集群是否就绪或已挂起;任务状态反映任务执行情况,两者含义不同。集群
READY不代表某个任务执行成功。 - Worker 状态:就绪 N / 期望 M:展示已就绪 Worker 数和控制器报告的当前期望数量;控制器尚未报告期望值时,使用集群配置中的副本数。自动伸缩时,期望值会随负载变化,不等于固定的上限。
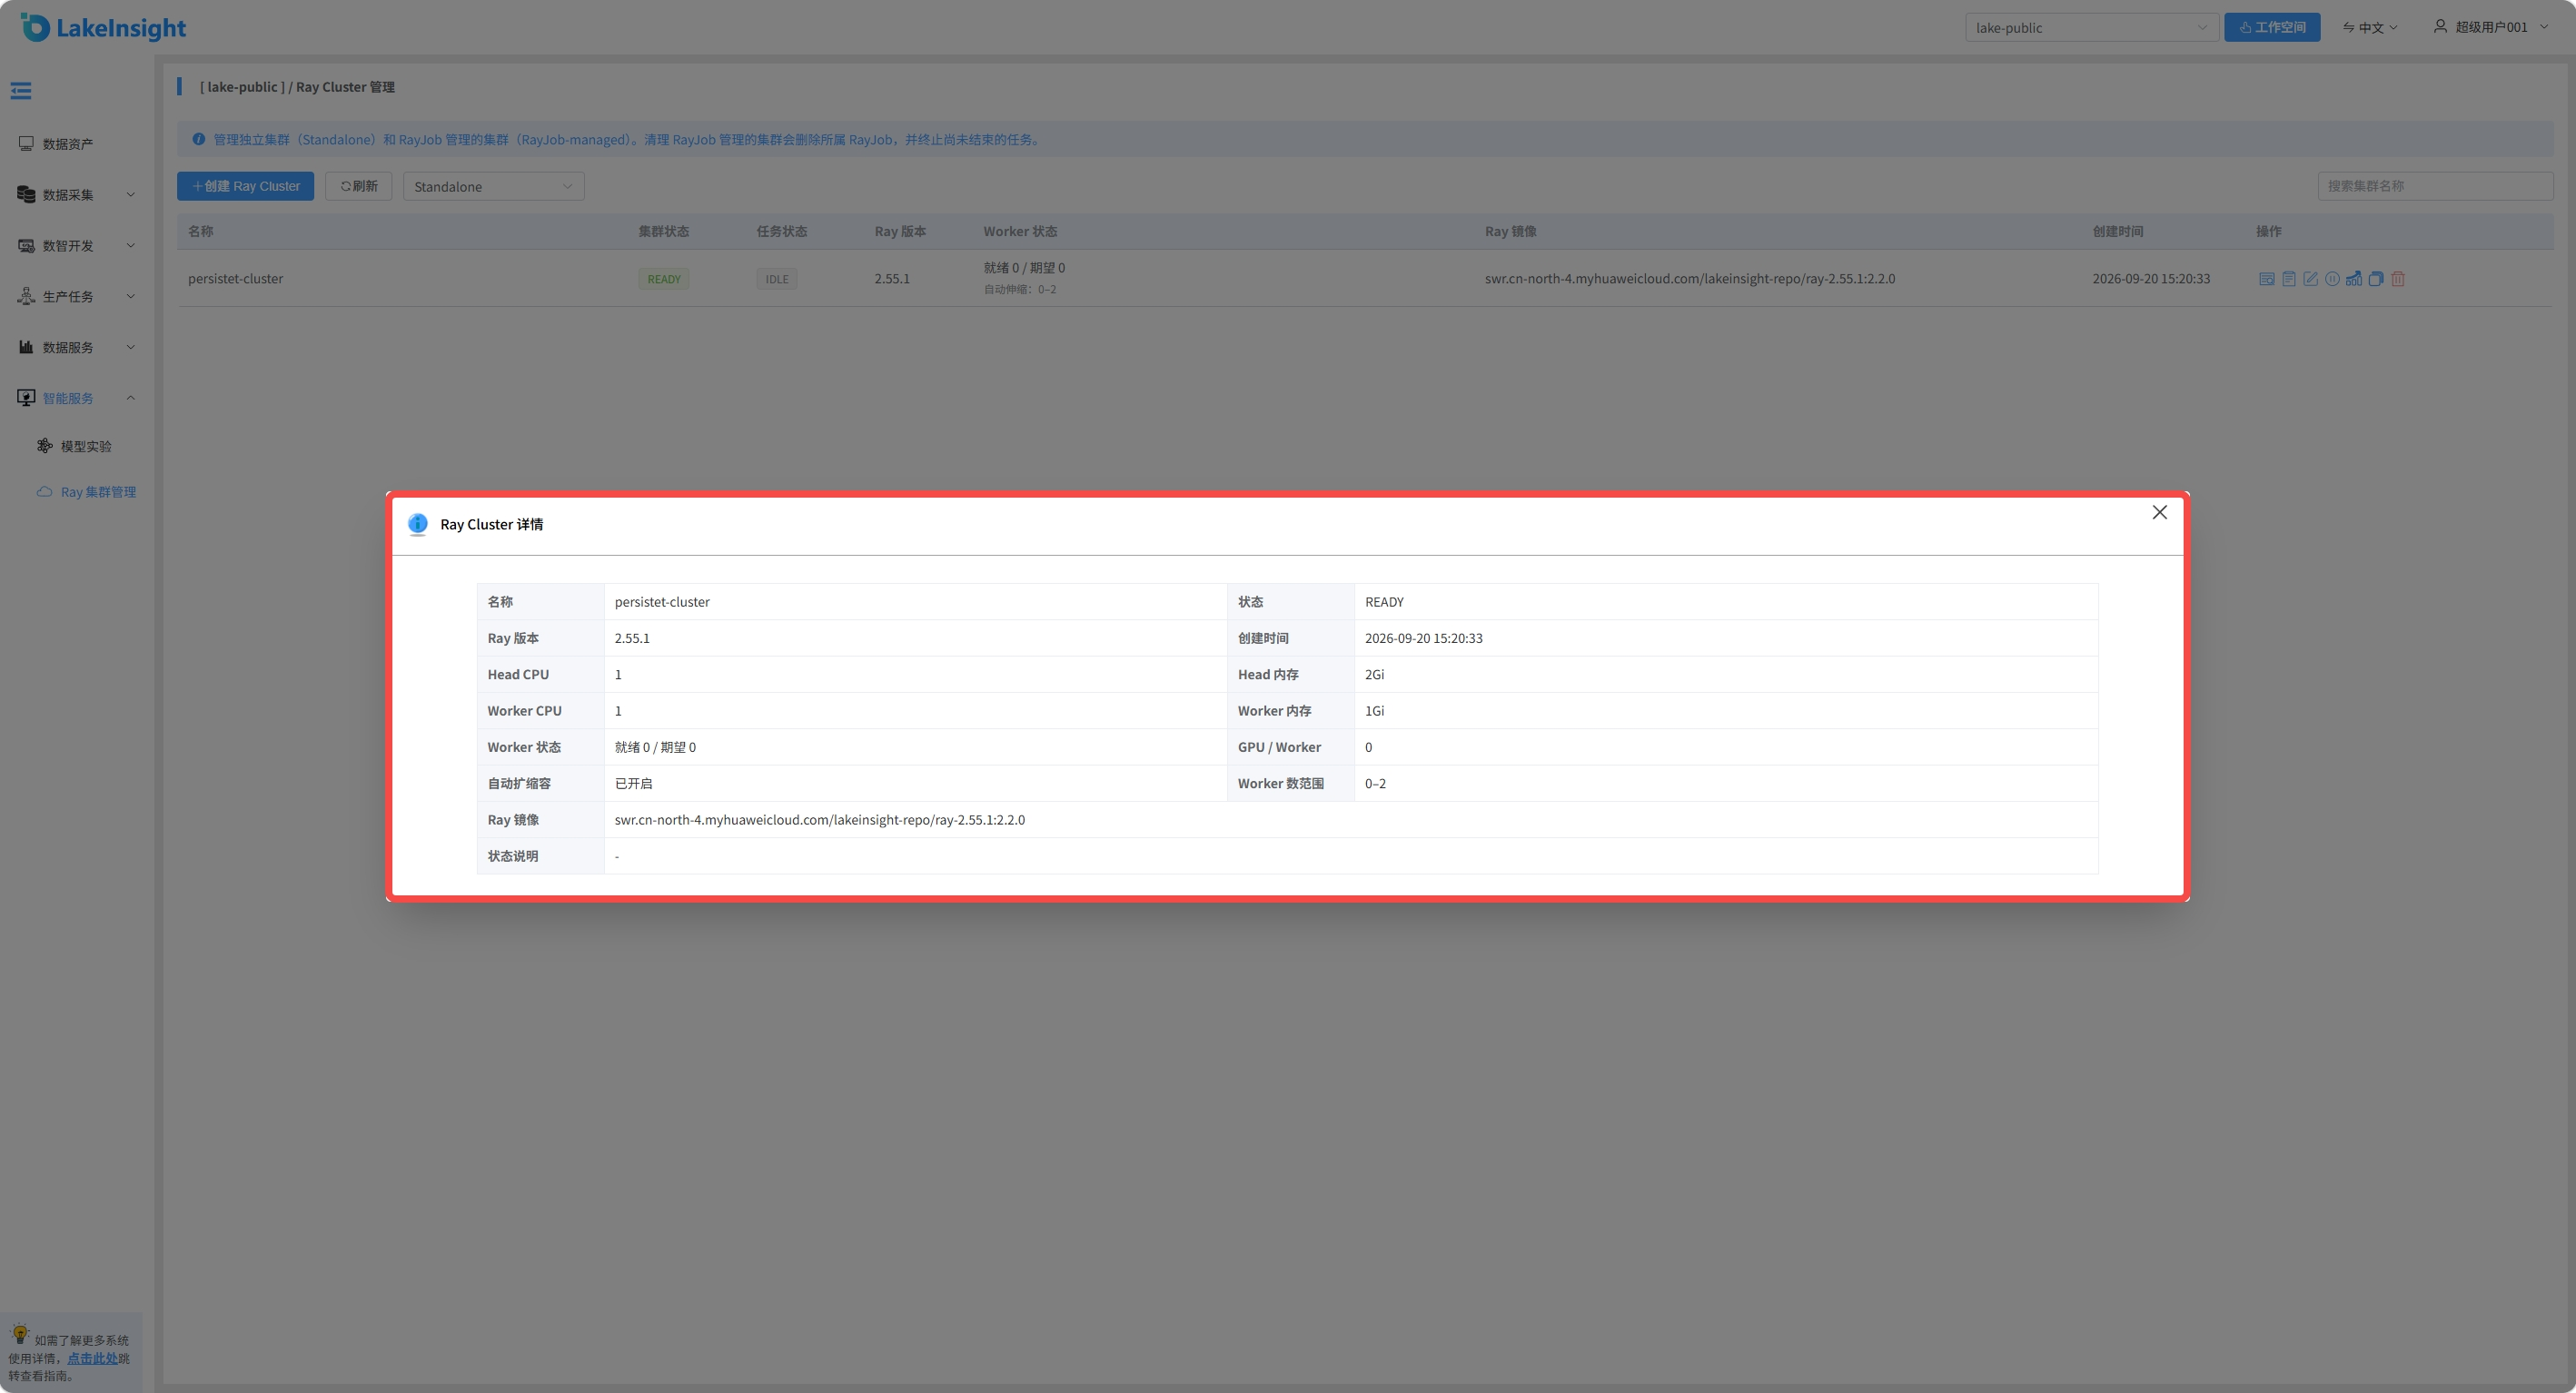
就绪 0 / 期望 0在下限为零且没有 Worker 需求时是正常的。 - 详情中查看 Head/Worker 的 CPU、内存、GPU、伸缩范围及镜像。列表和状态按轮询刷新,不是瞬时同步。
点击操作栏中的 详情,可以查看集群的 Ray 版本和镜像、Head/Worker 单节点资源、GPU 数量、自动伸缩状态及 Worker 范围。这里展示的是集群当前配置;自动伸缩集群的实时 Worker 数以列表状态或 Dashboard 为准。
查看诊断日志和 Dashboard
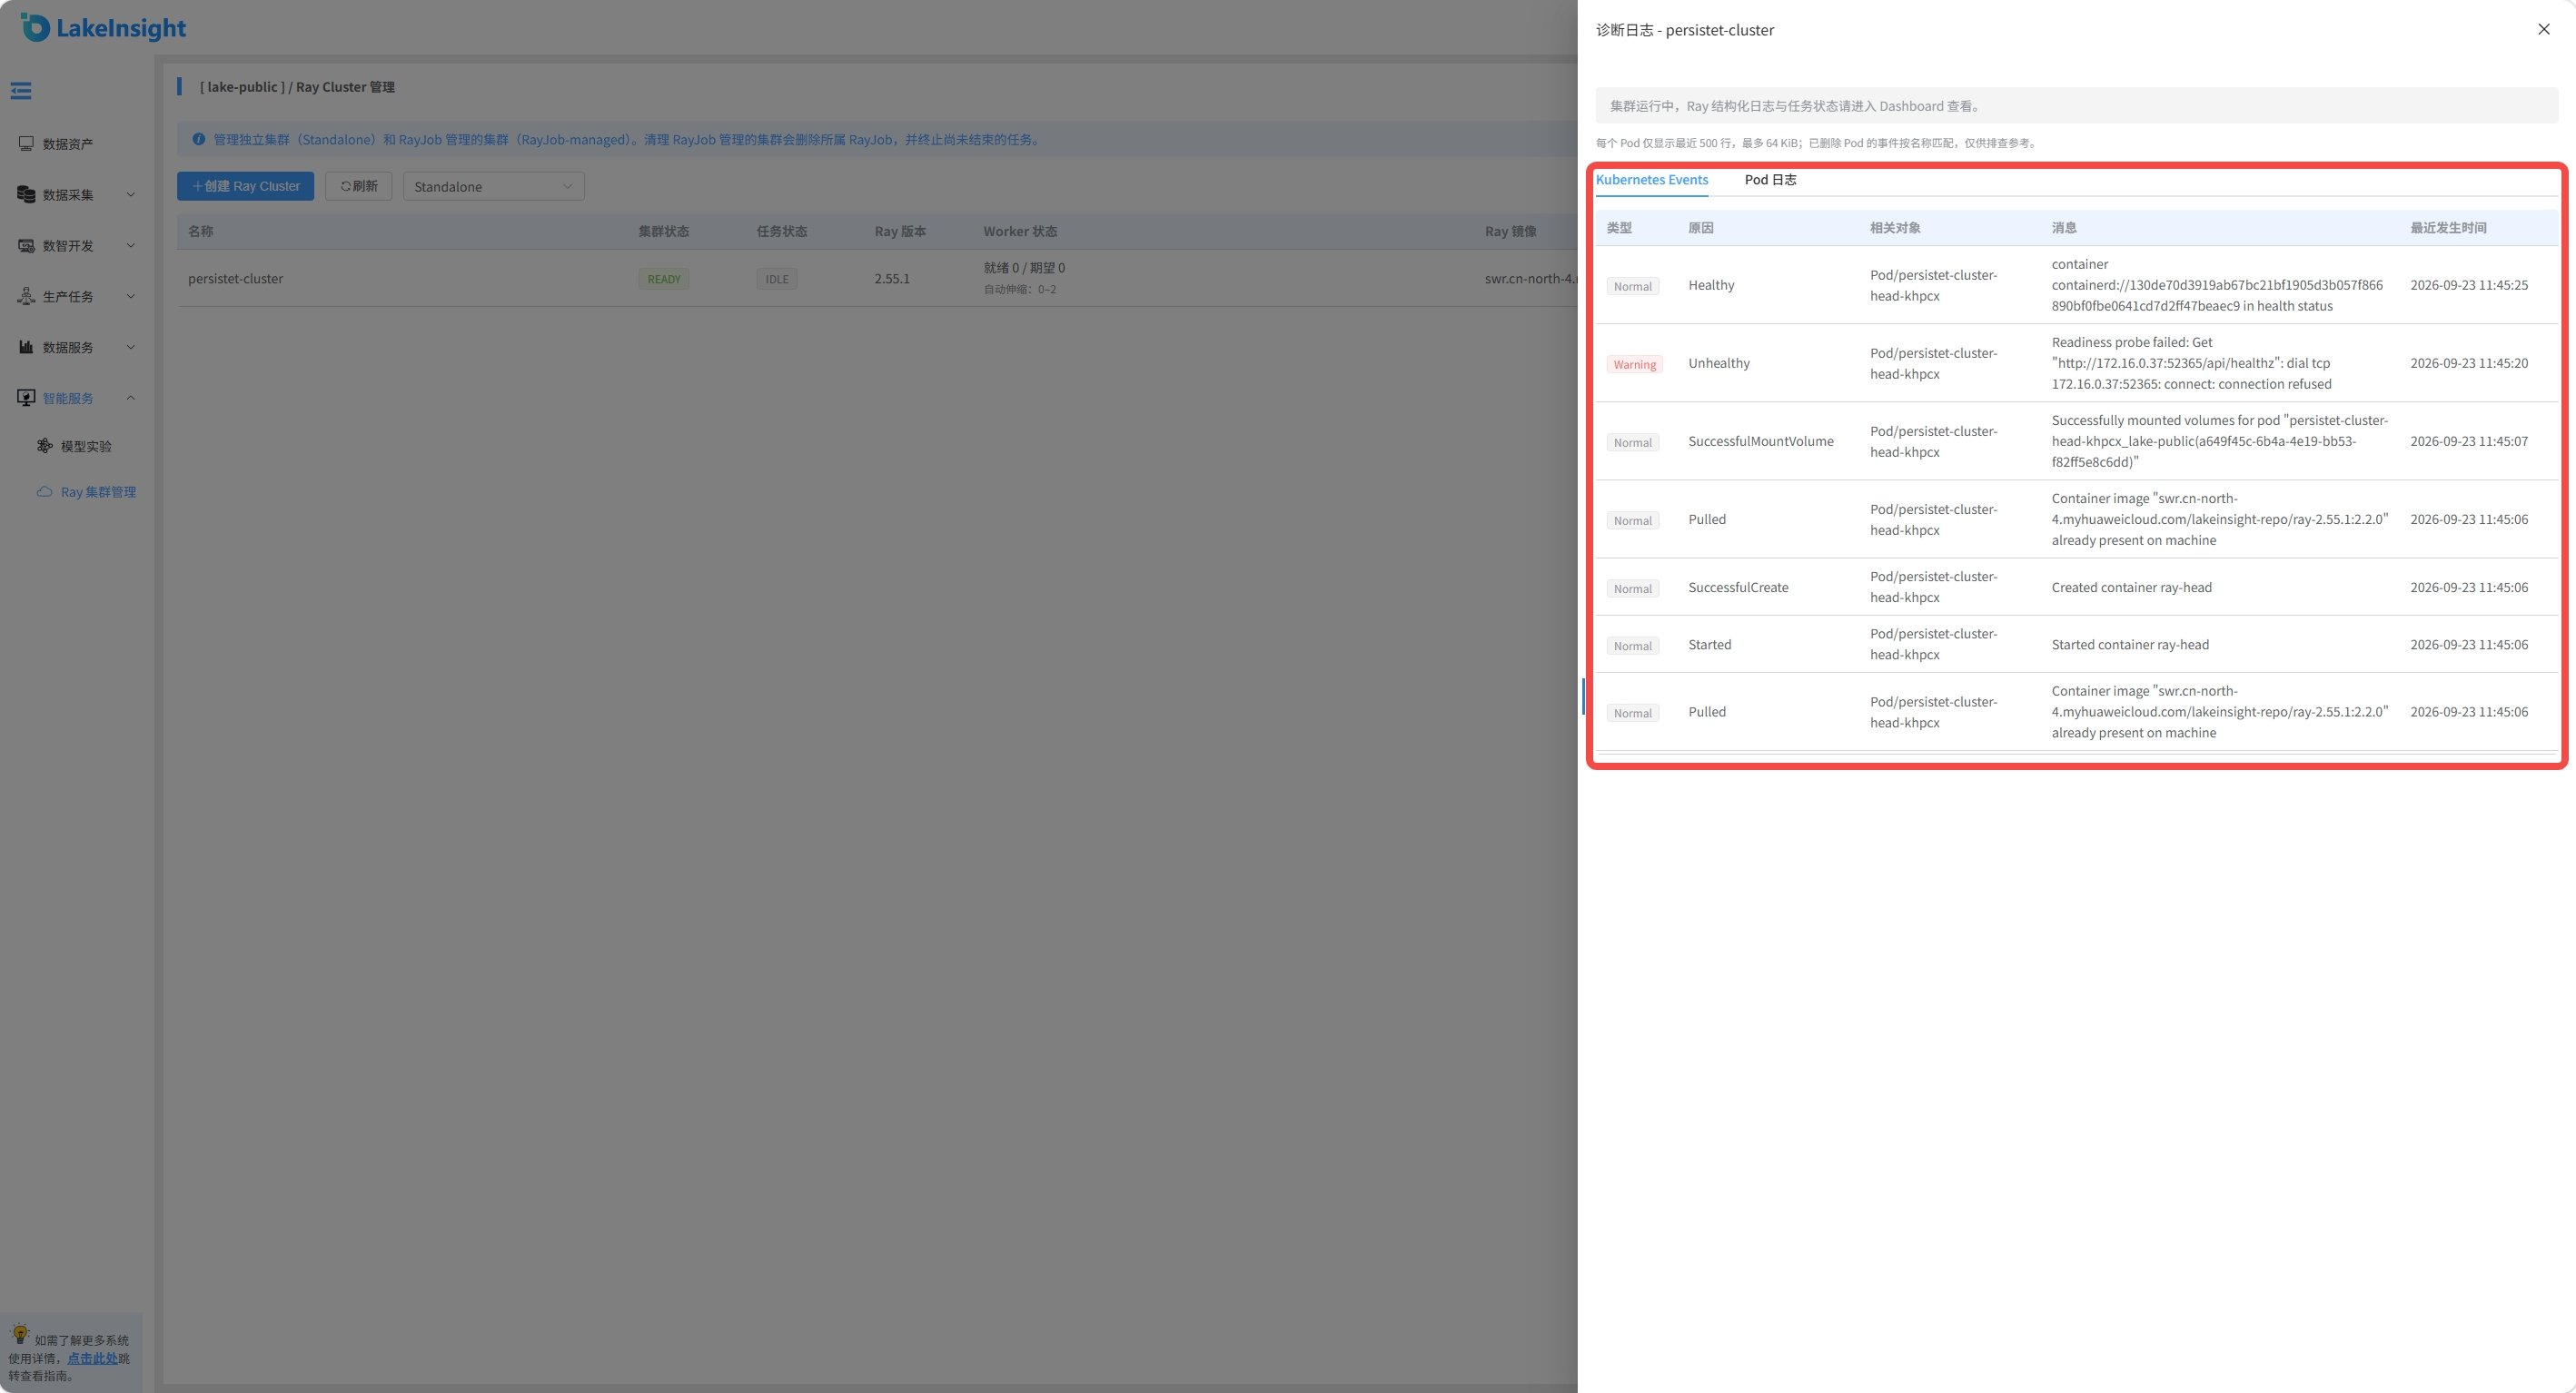
点击 诊断日志可以查看集群相关的 Kubernetes Events,以及当前 Head/Worker Pod 的容器日志。它适合排查镜像拉取失败、GPU 或其他资源不足、调度失败、Pod 启动失败等 Kubernetes 层问题。页面只保留有限的最近日志;Pod 删除后不保证还能查看其容器日志。
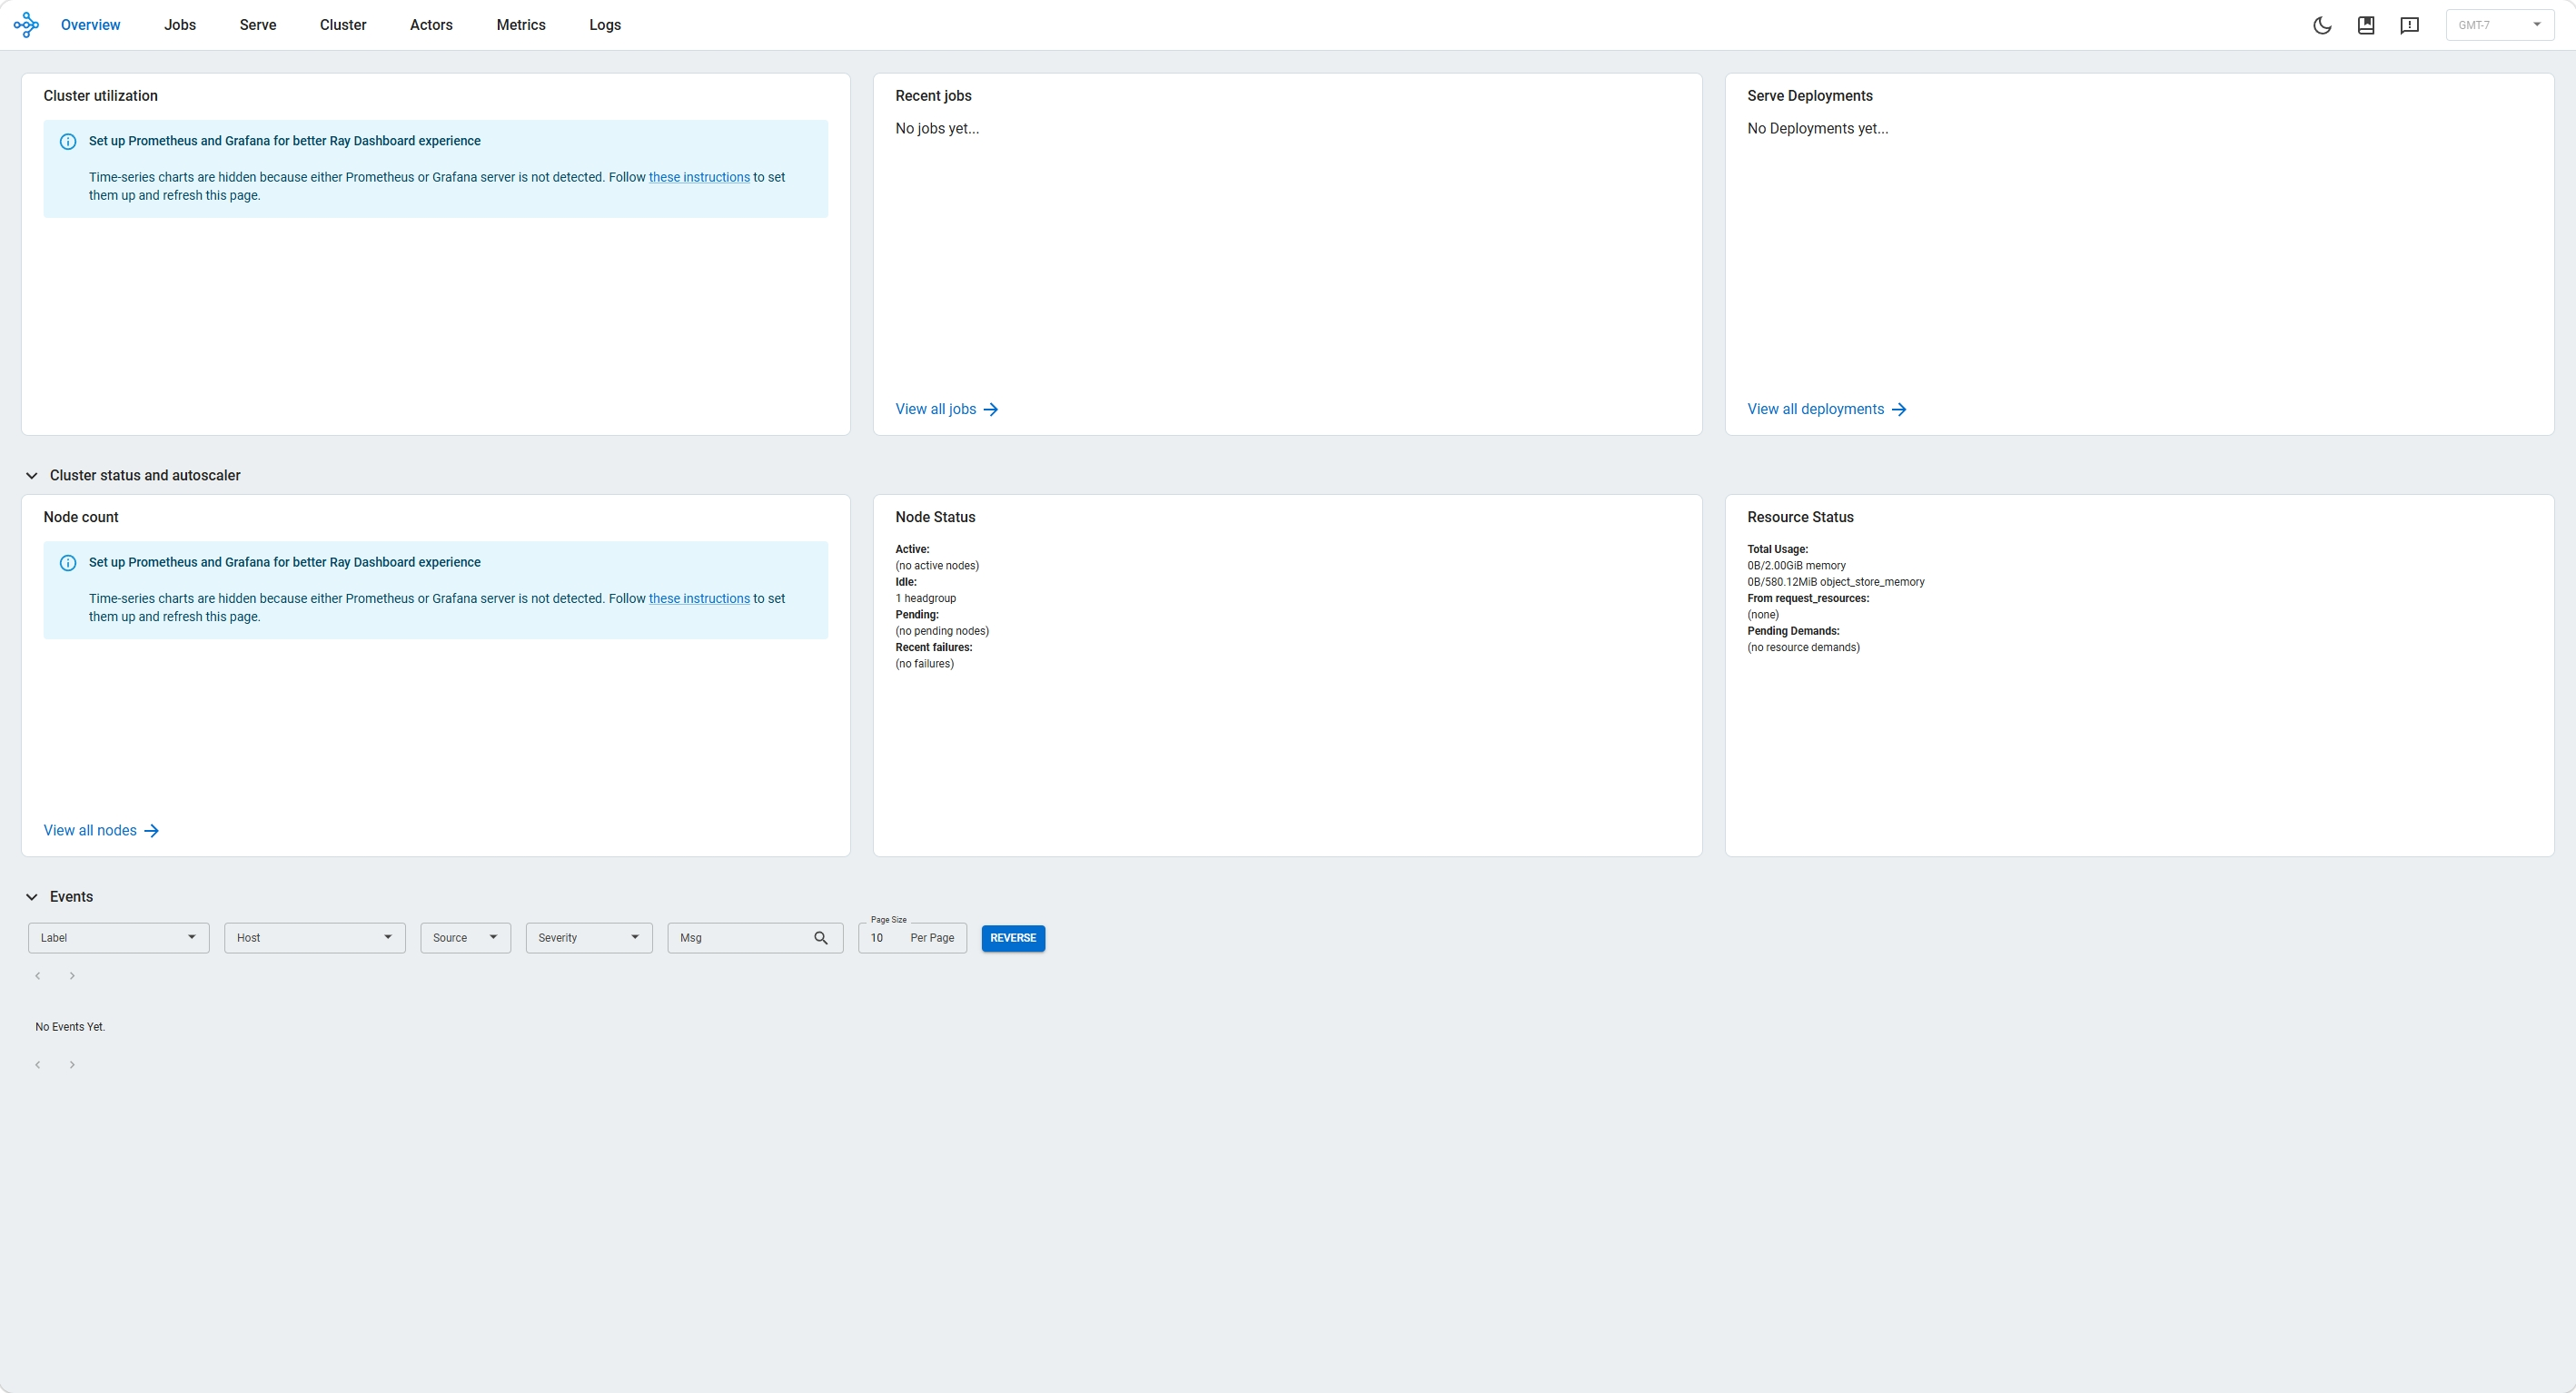
集群达到 READY 后,优先点击操作栏中的 进入 Dashboard查看 Ray 的集群资源、作业、任务和运行日志。Dashboard 更适合分析已经提交到 Ray 的作业;如果 Head 尚未启动、Dashboard 不可达或者 Pod 未就绪,再回到诊断日志查看 Kubernetes Events 和 Pod 日志。
绑定 Ray 任务
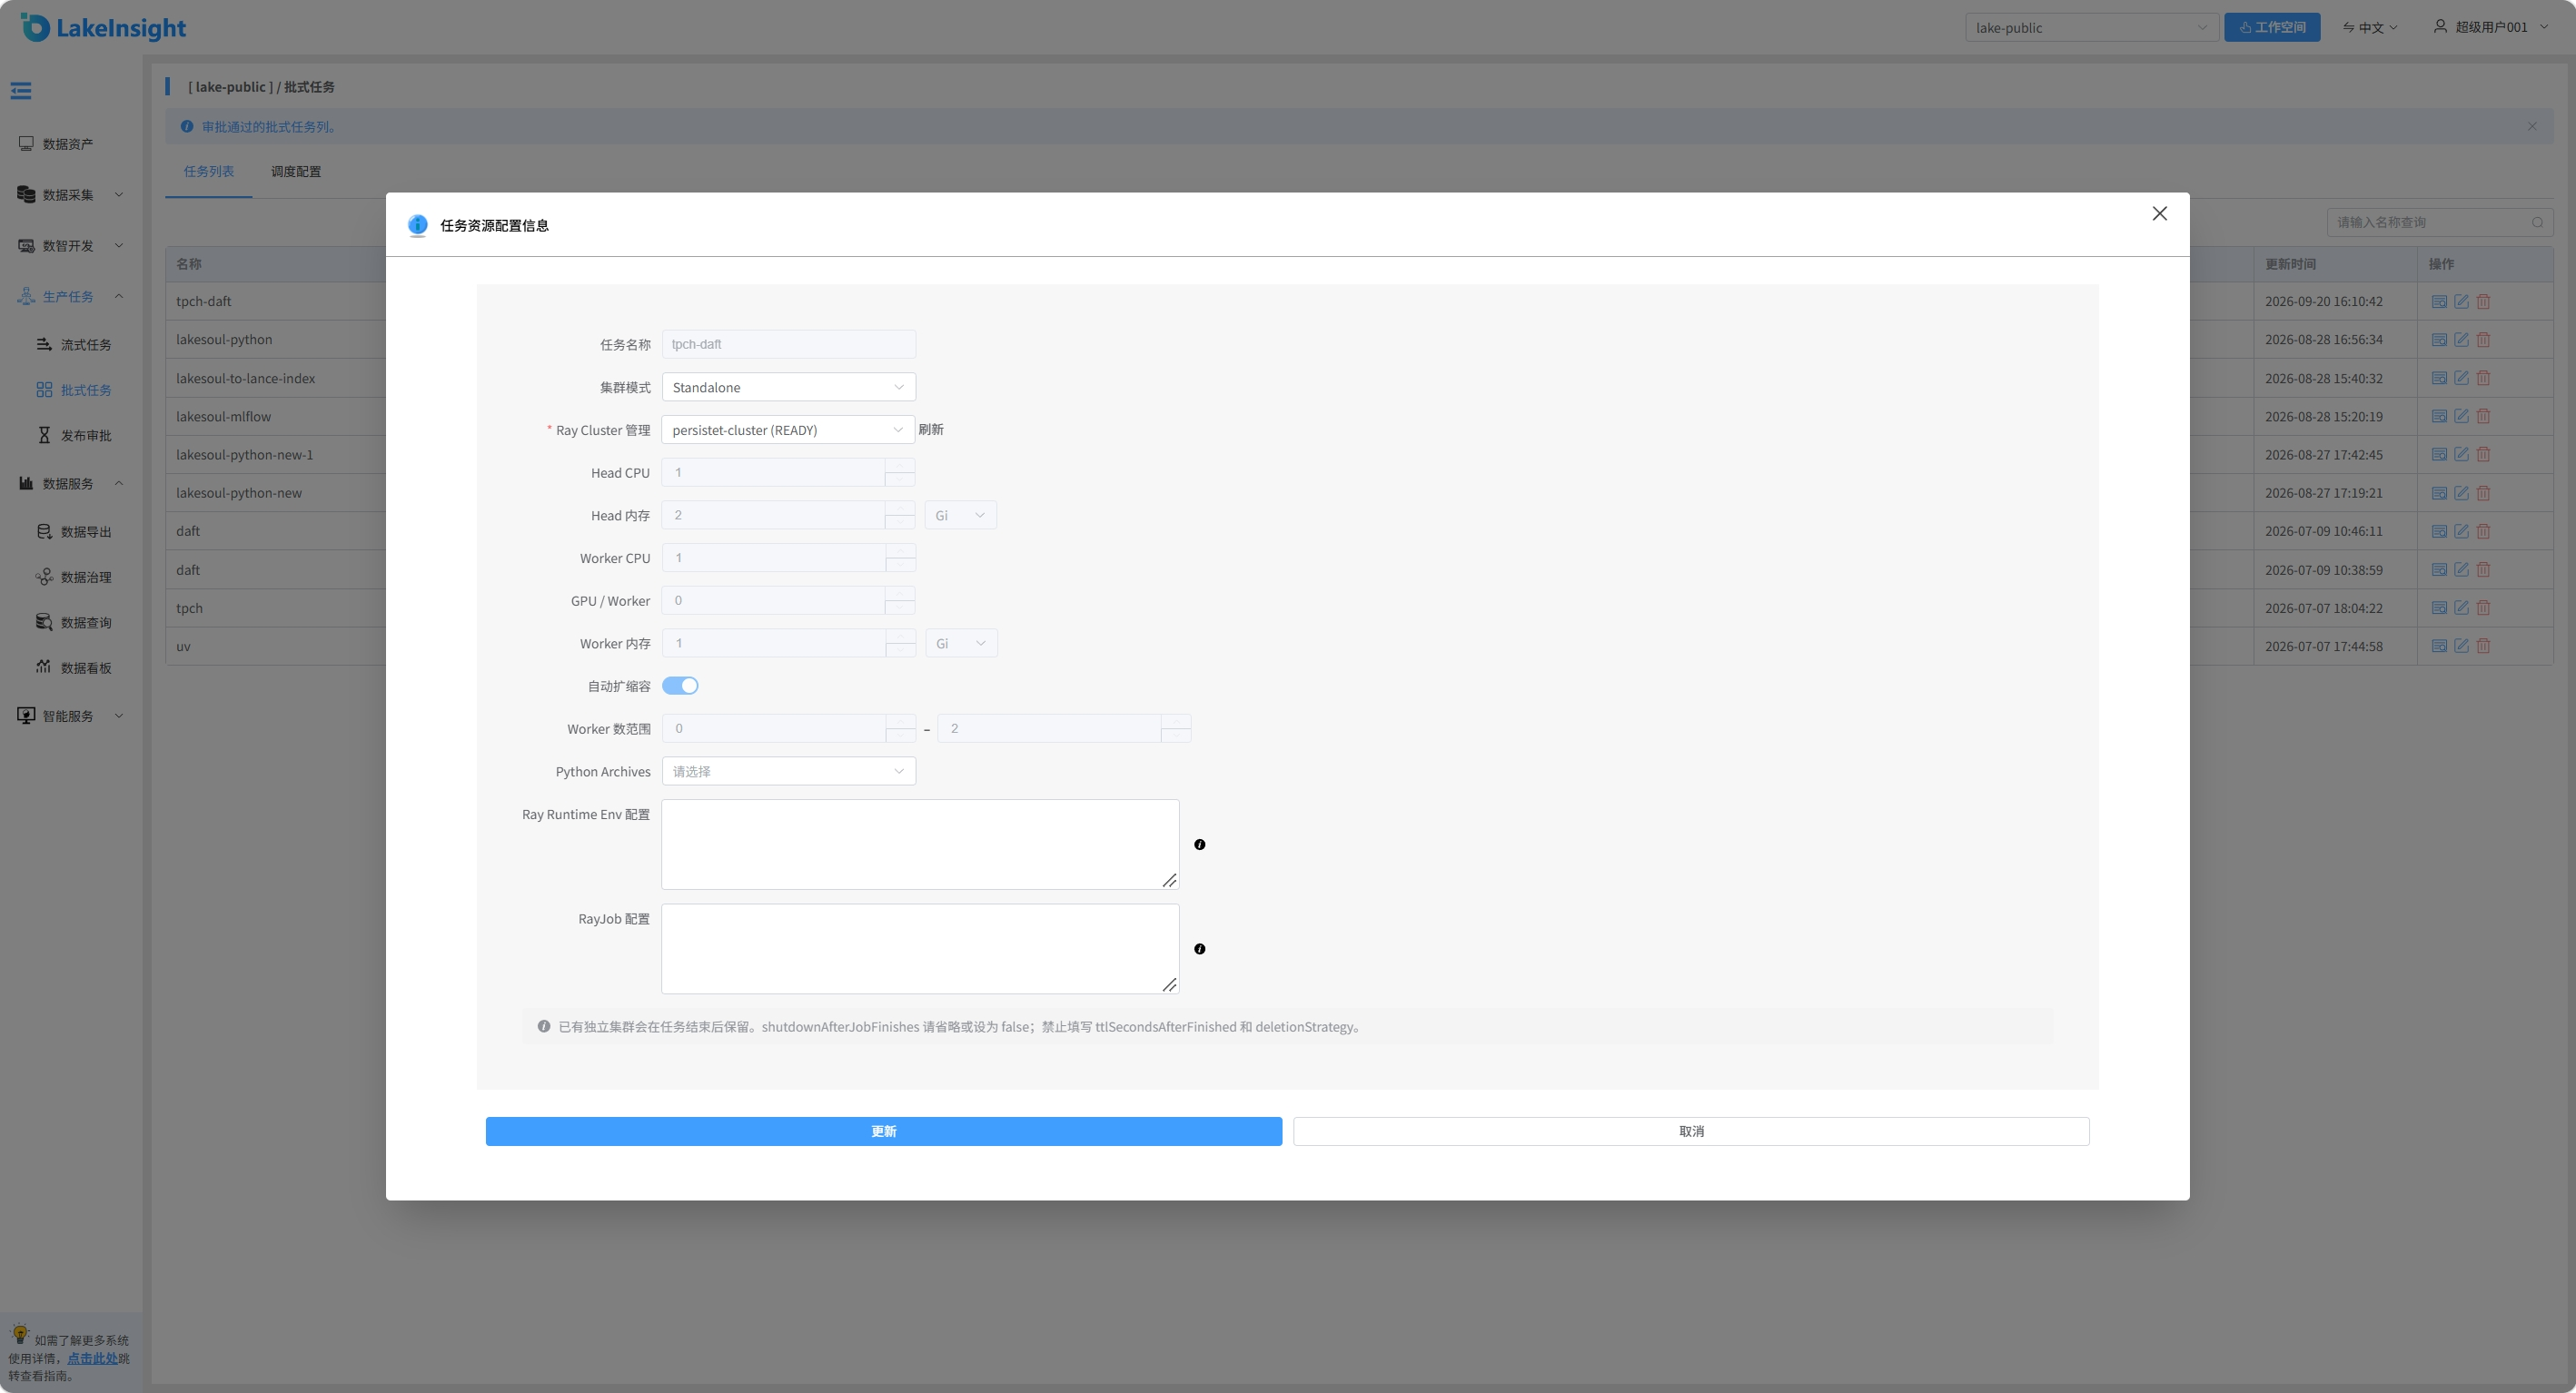
在 IDE 发布 Ray 任务或编辑已上线任务时,选择 Standalone,再选择当前工作空间中已就绪、未停止的集群。Head/Worker 资源只读显示集群当前配置;任务使用集群自身镜像。项目包、Python Archives 和 Runtime Env 仍是任务级配置。
任务上线后,可以在生产任务列表中打开该任务的 任务资源配置信息,修改集群模式或更换绑定的集群,点击 更新保存。
Standalone:选择要绑定的 Ray Cluster 后,Head/Worker 的 CPU、内存、GPU、自动扩缩容及 Worker 数量范围与所选集群当前配置一致,在任务配置中只读展示,不能单独修改。Python Archives、Ray Runtime Env 和 RayJob 配置仍可按任务需要填写。
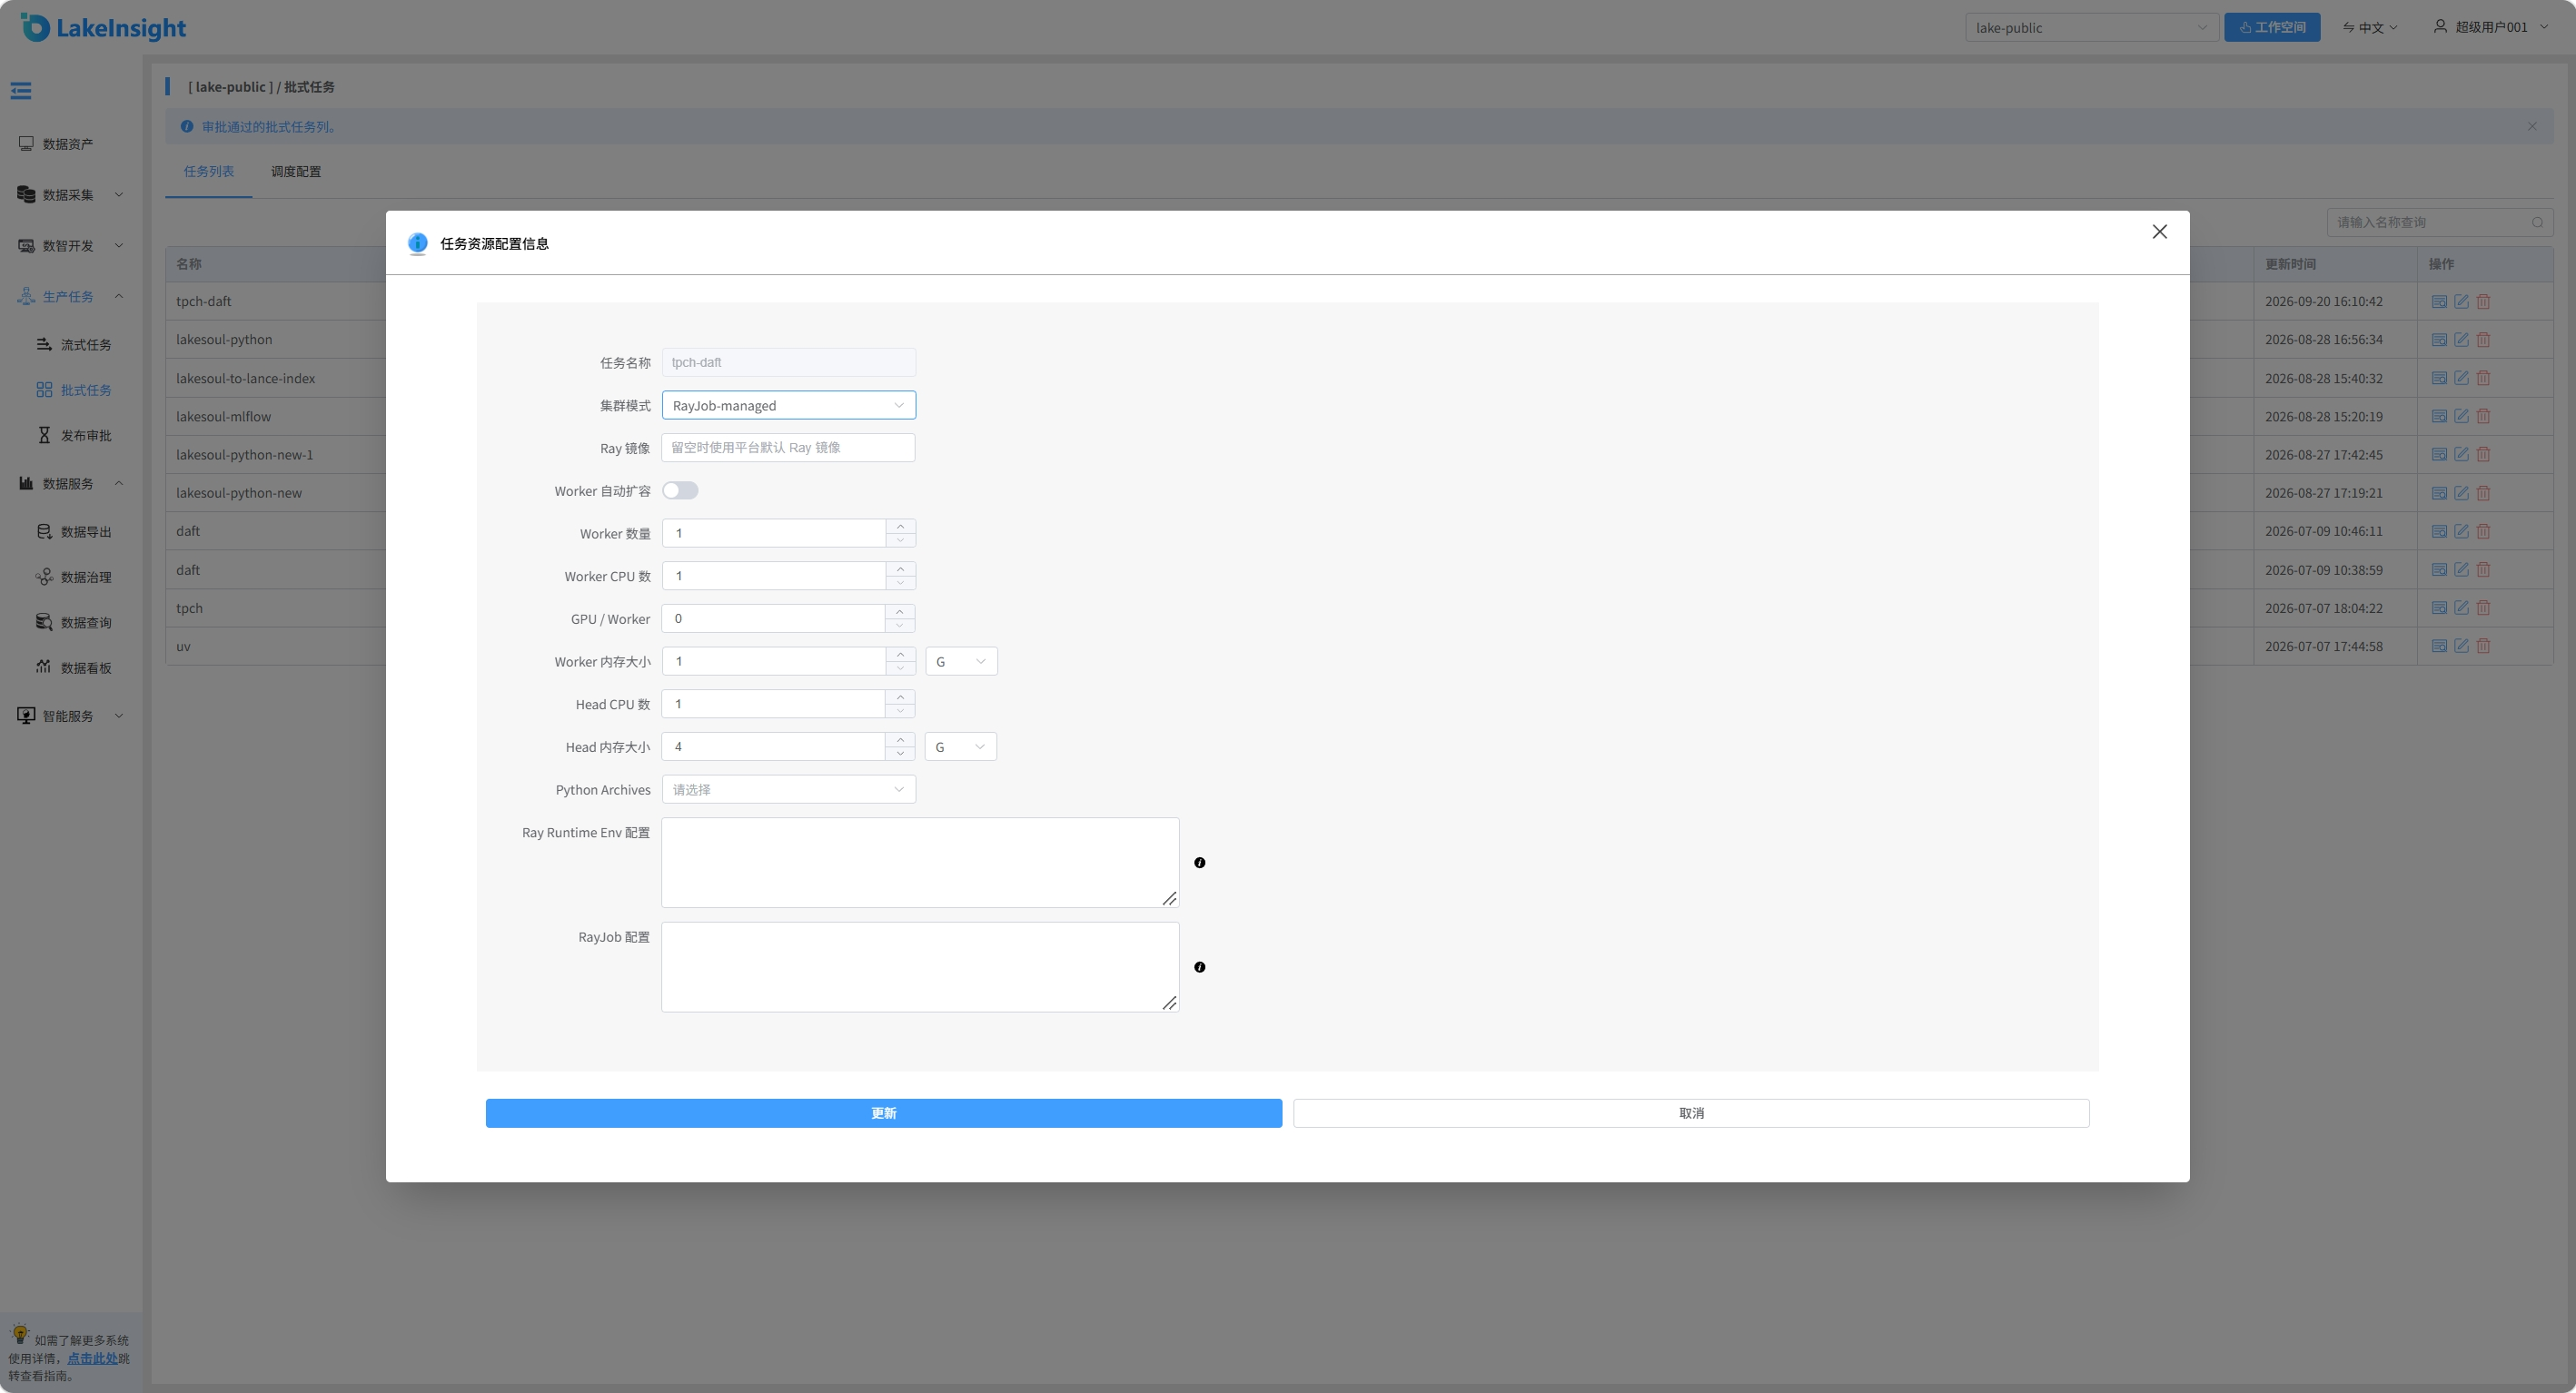
RayJob-managed:任务运行时创建专用的 RayJob-managed 集群,可以在此配置 Ray 镜像、Head/Worker 的 CPU 和内存、GPU / Worker,以及固定 Worker 数量或自动扩缩容上下限。Python Archives、Ray Runtime Env 和 RayJob 配置也可按任务需要填写。
绑定记录包含集群名称和 UID。删除后即使重建同名集群,原任务也必须重新选择集群;平台不会自动绑定到同名的新集群。切换任务的集群配置不会将已经运行的作业迁移到另一个集群。
已有 Standalone 集群的 RayJob 配置禁止 ttlSecondsAfterFinished 和整个 deletionStrategy,shutdownAfterJobFinishes 只能省略或设为 false。完整说明与示例见 开发环境中的 Ray Job 发布配置。
停止、编辑、启动和删除
- 停止:挂起 Standalone 集群并释放其 Head/Worker Pod。集群上的运行任务会被中断,平台对应活跃任务记录会标记失败;停止不会等待任务自然结束。执行前检查界面提示的影响。
- 编辑:先停止集群,等待状态为
SUSPENDED后再修改镜像或资源配置。保存后启动集群使新配置生效。 - 启动:恢复集群,等待
READY后提交新任务。启动集群不会自动恢复之前已失败的任务。 - 删除:释放集群及其 Pod。除运行任务外,还应检查绑定到该集群的任务;它们后续运行前需要重新选择集群。
清理 RayJob-managed 集群
切换到 RayJob-managed 查看任务创建的集群和所属 RayJob。它们通过任务配置管理资源,不作为供其他任务绑定的 Standalone 集群。
清理资源会删除所属 RayJob 及关联集群;尚未结束的任务会被终止。所属 RayJob 已不存在的残留集群也可清理。清理前保存需要排查的日志,因为相关 Pod 删除后可能无法再查看日志。
未显式配置清理策略时,平台默认添加 shutdownAfterJobFinishes: true 和 ttlSecondsAfterFinished: 1800,在任务结束 30 分钟后自动回收 RayJob-managed 集群。可通过任务的 RayJob 配置覆盖此策略:设置 shutdownAfterJobFinishes: false 关闭自动回收,或使用自定义 TTL、deletionStrategy.deletionRules。显式清理配置优先,不会混入默认字段;Standalone 集群不受此默认策略影响。新默认值仅用于后续提交的 RayJob,不会修改已创建的资源。